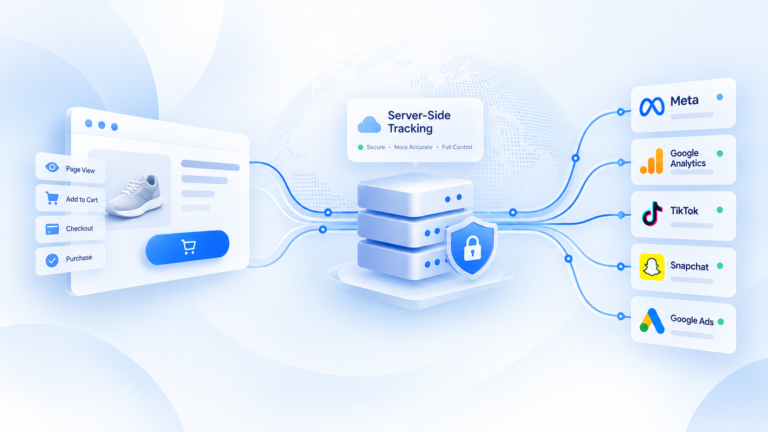
Server-Side Tracking مُدار أم DIY Server-Side GTM هو في الأساس قرار عن مَن سيتحمل الإعداد والمراقبة والـdebugging والصيانة المستمرة.
الإجابة المختصرة: DIY قد يكون مناسبًا إذا كان لديك فريق تقني قادر على امتلاك الـstack فعليًا، ويحتاج تحكمًا عميقًا ومستعدًا لتشغيله وصيانته باستمرار. أما Managed Server-Side Tracking فينقل جزءًا أكبر من مسؤولية Event Logic وValidation وDeduplication والمراقبة وحل المشاكل إلى خدمة مستمرة. لا يوجد خيار أفضل للجميع. الأفضل هو الخيار الذي تستطيع الحفاظ على موثوقيته بعد يوم الإطلاق.
ماذا يتطلب إعداد Server-Side GTM بنفسك؟
DIY لا يعني فقط تشغيل Server Container ثم اعتبار المشروع منتهيًا.
Tracking System تعمل كسلسلة كاملة.
شخص ما يجب أن يعرف من أين يأتي Event، وكيف تتم معالجته، وما Identifiers المطلوبة، وكيف يتم التعامل مع Duplicates، وأي Destinations تستقبل الحدث، وماذا يحدث عندما يتوقف جزء من المسار عن العمل.
في DIY، هذه المسؤولية تظل عند فريقك.
بالنسبة لبعض الشركات، هذا بالضبط ما تريده. لديها Engineers أو Tracking Specialists، وتفضّل امتلاك البنية والمنطق بشكل مباشر.
بالنسبة لشركات أخرى، Infrastructure نفسها ليست أصعب جزء.
الجزء الأصعب هو تشغيلها بشكل مستمر.
Infrastructure
فريق DIY يملك مسؤولية البيئة Server-Side نفسها.
المطلوب ليس Architecture واحدة محددة للجميع؛ لا توجد Recipe موحدة للاستضافة تناسب كل فريق أو حالة استخدام.
النقطة المهمة هي الملكية.
فريقك مسؤول عن بقاء البنية صالحة لمسار Tracking، وعن التأكد أن أي تغيير في البيئة لا يكسر Event Delivery بصمت.
إعداد Tags وEvents
الفريق يملك أيضًا Event Logic.
يعني هذا تحديد:
- Event names.
- الحقول المطلوبة.
- Value وCurrency.
- Identifiers.
- طريقة تنسيق Browser وServer.
- قواعد Deduplication.
- Routing للوجهات المدعومة.
وجود Server يعمل بشكل ممتاز مع Event Logic ضعيفة يظل Tracking ضعيفًا.
Infrastructure وحدها لا تكفي.
Monitoring
DIY يحتاج طريقة واضحة لمعرفة متى توقف Event Path عن التصرف كما هو متوقع.
لو انخفضت Purchase Events فجأة، أو ظهرت Duplicates، أو تغيرت Values، أو توقفت Destination عن استقبال Events، يجب أن يلاحظ أحد المشكلة ويبدأ التحقيق.
بدون Monitoring، يمكن لتنفيذ "شغال تقنيًا" أن يظل مكسورًا من ناحية البيانات فترة طويلة قبل أن ينتبه البيزنس.
Maintenance
Tracking يتغير مع الوقت.
الموقع يتغير.
Event definitions تتغير.
متطلبات Destinations تتغير.
Logic جديدة تُضاف، وأجزاء قديمة تحتاج إزالة.
في DIY، فريقك يملك كل هذه التحديثات، ومعها Regression Risk الناتج عن أي تغيير.
وهذا هو الجزء الذي يتم تجاهله كثيرًا عندما تتم المقارنة على أساس مجهود Setup الأول فقط.
ماذا يتغير مع Managed Server-Side Tracking؟
الخدمة المُدارة لا تلغي الحاجة إلى Tracking Architecture صحيحة.
الذي يتغير هو توزيع المسؤولية التشغيلية.
بدل أن يكون المشروع "ركب Server وسلمه"، يصبح هناك Operating Layer مستمر حول Event Path نفسها.
ضمن النطاق الموثق، قد يشمل ذلك Event Handling وValidation وDeduplication Controls وجودة Identifiers ومراقبة Delivery والـTroubleshooting.
وده مهم لأن Tracking Failures ليست دائمًا Infrastructure Failures.
Server قد يكون Online، والبيانات نفسها خاطئة.
Purchase Value قد تكون غير صحيحة.
Event ID قد تختفي.
نفس Order قد يتم إرسالها من مسارين بدون Coordination صحيح.
Destination قد تتوقف عن استقبال Event رغم أن الجزء السابق من المسار يبدو طبيعيًا.
Managed Tracking يكون مفيدًا عندما يريد البيزنس جهة تملك جزءًا أكبر من هذه المسؤولية التشغيلية، وليس مجرد جهة تستضيف Server.
هذا لا يعني أن البيزنس يتنازل عن كل التحكم.
يعني أن حدود المسؤولية تتغير.
ويجب أن تكون هذه الحدود واضحة، لأن Managed لا تعني تلقائيًا أن كل Source أو Destination أو Workflow مدعوم.
التكلفة ليست Hosting فقط
أسهل مقارنة هي النظر إلى تكلفة Infrastructure فقط.
لكن هذا يعطي صورة ناقصة.
تكلفة Tracking Stack تشمل أيضًا الوقت والأشخاص اللازمين للحفاظ عليها موثوقة.
Hosting رخيصة قد تكون فوق Operating Model مكلف إذا كان Engineers يحتاجون باستمرار للتحقيق في Missing Events، وإصلاح Custom Logic، ومتابعة تغييرات Destinations.
لا توجد أرقام عامة موثقة تثبت أن DIY أرخص دائمًا أو أن Managed أوفر دائمًا.
لذلك المقارنة الصحيحة تكون في نوع العمل الذي يخلق كل خيار.
وقت Engineering
أي Tracking Work ينافس أولويات Engineering الأخرى.
كل Change أو Incident أو Debugging session أو Migration يستهلك وقتًا كان يمكن استخدامه في مكان آخر.
وقد يكون هذا Trade-off منطقيًا جدًا إذا كانت Tracking Infrastructure جزءًا استراتيجيًا من قدرات الفريق.
المشكلة تبدأ عندما يكون Tracking "مسؤولية Engineering" نظريًا، لكن لا يوجد شخص لديه وقت كافٍ لتشغيلها جيدًا.
Monitoring
شخص ما يجب أن يراقب النظام.
إذا لم يعرف الفريق بسرعة أن Purchase Delivery انخفضت أو أن Duplicates ارتفعت، فالتكلفة ليست فقط وقت Debugging لاحقًا.
هناك أيضًا فترة يمكن أن يتخذ فيها Marketing قرارات اعتمادًا على Data غير موثوقة.
Monitoring جزء من تشغيل النظام، وليس Add-on بعد التنفيذ.
Debugging
Tracking Failure قد يعبر أكثر من Layer.
المشكلة قد تكون في Source Event.
أو Browser Path تختلف عن Server Path.
أو Deduplication فشل.
أو Destination لم تستقبل Event.
معرفة السبب تحتاج وقتًا وفهمًا للمسار كاملًا.
في DIY، مسؤولية Troubleshooting تظل داخل الشركة.
Upgrades والتغييرات
Tracking ليست Static.
متطلبات Platform قد تتغير.
الموقع نفسه يتغير.
Data Model تتطور.
Events جديدة تُضاف.
السؤال ليس هل ستحدث تغييرات أم لا.
السؤال هو: مَن سيتحمل تنفيذها بأمان والتأكد أن Measurement القديمة لم تنكسر بعدها؟
التحكم والملكية والقدرة على مراقبة النظام
DIY عادةً يعطي أوضح شكل من أشكال Technical Ownership المباشرة.
فريقك يملك Infrastructure وConfiguration وEvent Rules وChange Process.
هذا مفيد عندما يحتاج البيزنس Customization عميقة أو لديه Data/Tracking capability قوية داخليًا.
لكن Ownership لها وجهان.
أنت تملك المرونة.
وأنت أيضًا تملك الفشل.
إذا اختفت Event في وقت غير مناسب، أو Deployment كسرت Purchase Tag، أو تغيير في Destination سبب Regression، فريقك مسؤول عن العثور على السبب وإصلاحه.
Managed Tracking ينقل جزءًا من هذا العبء التشغيلي إلى Service Provider.
لكن في المقابل، تحتاج إلى معرفة واضحة:
ما الذي تديره الخدمة؟
ما الذي يظل مسؤوليتك؟
وما Evidence المتاحة لك عندما يحدث Failure؟
هنا تظهر أهمية Observability.
سواء النظام DIY أو Managed، يجب أن تستطيع الإجابة عن أسئلة عملية:
- هل تم إنشاء Event؟
- هل تمت معالجتها؟
- هل Deduplication عمل بشكل صحيح؟
- هل تم إرسالها؟
- هل Destination استقبلتها؟
- وإذا حدث Failure، في أي Layer حدث؟
إذا لم يستطع أي من الخيارين إعطاءك هذه الإجابات، فالمشكلة ليست DIY مقابل Managed.
المشكلة أن Tracking Stack نفسها غير قابلة للمراقبة بما يكفي.
إطار قرار لاختيار DIY أو Managed Tracking
لا تختار بناءً على أي خيار يبدو "أكثر تقنيًا".
اختار بناءً على Operating Model يستطيع فريقك الحفاظ عليها.
DIY يكون منطقيًا أكثر عندما:
- لديك Technical Capacity حقيقية لامتلاك الـstack.
- تحتاج Customization عميقة.
- التحكم المباشر في Infrastructure وEvent Logic مهم.
- هناك شخص واضح مسؤول عن Monitoring وDebugging.
- الفريق مستعد للصيانة المستمرة، وليس فقط Setup أول مرة.
Managed Tracking يكون منطقيًا أكثر عندما:
- تريد Reliable Event Infrastructure بدون تحويل Engineering إلى Tracking Support Desk.
- Monitoring وTroubleshooting المستمران مهمان بقدر Setup.
- Tracking Problems تستهلك وقت Developers بشكل متكرر.
- تحتاج مساعدة تشغيلية في Validation وDeduplication وIdentifiers وDelivery ضمن Scope موثقة.
- تكلفة Internal Maintenance بدأت تصبح صعبة التبرير.
وهناك احتمال ثالث مهم:
ربما لا تحتاج تغيير Architecture الآن أصلًا.
إذا لم يتم تشخيص المشكلة الحالية، اختيار DIY أو Managed أولًا قد يعني حل المشكلة الخطأ.
Broken Source Event ستظل Broken في الخيارين.
Duplicate Purchase ناتجة عن Implementations غير منسقة ستظل تحتاج Root Cause واضح.
قبل Architecture Decision كبيرة، قارن Transactions الحقيقية بمسار Events وحدد ما الذي يفشل بالفعل.
وقتها يصبح السؤال أفضل من "هل نشتري Managed Tracking؟"
السؤال الصحيح هو:
أي Operating Model يعطينا التحكم والموثوقية وعبء الصيانة الذي نستطيع تحمله فعليًا؟
إذا كانت الإجابة فريقك الداخلي، فـDIY قد يكون مناسبًا.
إذا كانت الإجابة Managed Layer متخصصة بنطاق ومسؤولية واضحين، فـManaged قد يكون أفضل Fit.
وإذا لم تعرف بعد أين ينكسر Tracking الحالي، فشخّص المشكلة أولًا.
أدلة مرتبطة
الأسئلة الشائعة
ماذا يحتاج فريق DIY لصيانته؟
البنية والإعدادات وقواعد الأحداث والمراقبة والـdebugging والتحديثات وتغييرات الوجهات.
كيف تختلف الخدمة المُدارة عن الاستضافة؟
الاستضافة توفر البنية، بينما Managed Tracking تشمل منطق الأحداث والتحقق وDeduplication والمراقبة وحل المشاكل.
ما التكاليف الخفية في DIY؟
وقت الهندسة والصيانة والمراقبة والـdebugging والمسؤولية التشغيلية؛ لا يوجد نموذج تكلفة رقمي عام ينطبق على كل Implementation.
متى تكون ملكية البنية مناسبة؟
عندما يملك الفريق قدرة تقنية وحاجة لتخصيص عميق واستعدادًا لتشغيل وصيانة الـstack باستمرار.
ماذا تقارن قبل اختيار DIY أو Managed؟
جهد التنفيذ والتحكم والملكية والمراقبة والـdebugging ومتطلبات الوجهات والصيانة.